数据检索与索引
数据检索与索引
在最基础的层面上,数据库需要做两件事:当你给它一些数据时,它应该存储这些数据;当你之后再询问时,它应该把数据返回给你。
如果真的要说数据的存储与检索,就不得不提一下磁盘的结构,磁盘有柱面、盘面、扇区的概念,用(柱面号、盘面号、扇区号)可以定位任意一个 “磁盘块”,读取磁盘块需要移动磁头和旋转扇区,所以一次查询读取磁盘块的次数(IO次数)对性能有很大影响。
假设一个磁盘块 512B、一条记录是 128B(唯一标识占 8B),那么 100 条记录需要放在 25 个磁盘块上,访问一条记录平均需要读取 12 个磁盘块。这样的性能实在是太差了,那么有什么办法可以优化呢?
案例提到每条记录的唯一标识占 8B,假如我们可以用 8B 标识一个物理地址(例如柱面+盘面+扇区+偏移量),那么 16B 可以标识一条记录对应的位置,一个磁盘块可以放 32 个这样的结构,那么 100 条记录需要 4 个磁盘块来存放。此时访问数据我们可以读取这4个磁盘块,进而定位出记录的具体位置,也就是平均的 2 次索引 IO + 1 次的数据 IO。通过多使用一部分空间,访问数据的速率提高了数倍,另外一般来讲这个标识是按照顺序排列的,这样可以支持范围查询,也可以快速定位数据是否存在(否则需要访问全部的磁盘块才知道数据是否存在)。
索引可以用来快速定位数据库中的数据,多叉树和哈希是实现索引的常见方案。
索引的实现选型
Redis 就是利用哈希来实现索引,快速地定位到 key 所在的位置。Redis 中定义了一个数组,当 key 到来时对 key 执行哈希函数,并对数组长度取余(取余实现上是位运算)得到 index,接着在数组[index] 的位置查看是否有当前 key,解决哈希冲突采用的是链表法。哈希索引实现简单,对于单个 key 的查询,能以 O(1) 的速度找到对应的数据。
数据结构布隆过滤器也是通过哈希来实现的,它的工作原理是这样的:有一个比较长的 bit 数组 bits,当 key 来时,用多个哈希算法对 key 计算多个哈希值,假设哈希值对数组长度取余后是(0,9,1),如果 bit[0]、bit[9]、bit[1] 的值均为 1,那么该 key 就可能存在;反之只要这三个元素的值有一个是 0,这个 key 就肯定不存在。布隆过滤器常用来缓解缓存穿透的问题。
哈希索引的缺点就是不支持范围查询和模糊查询,Mysql 数据库采用树结构来实现索引,树有非常多的形态,搜索树、平衡树、红黑树、B树、B+树…….
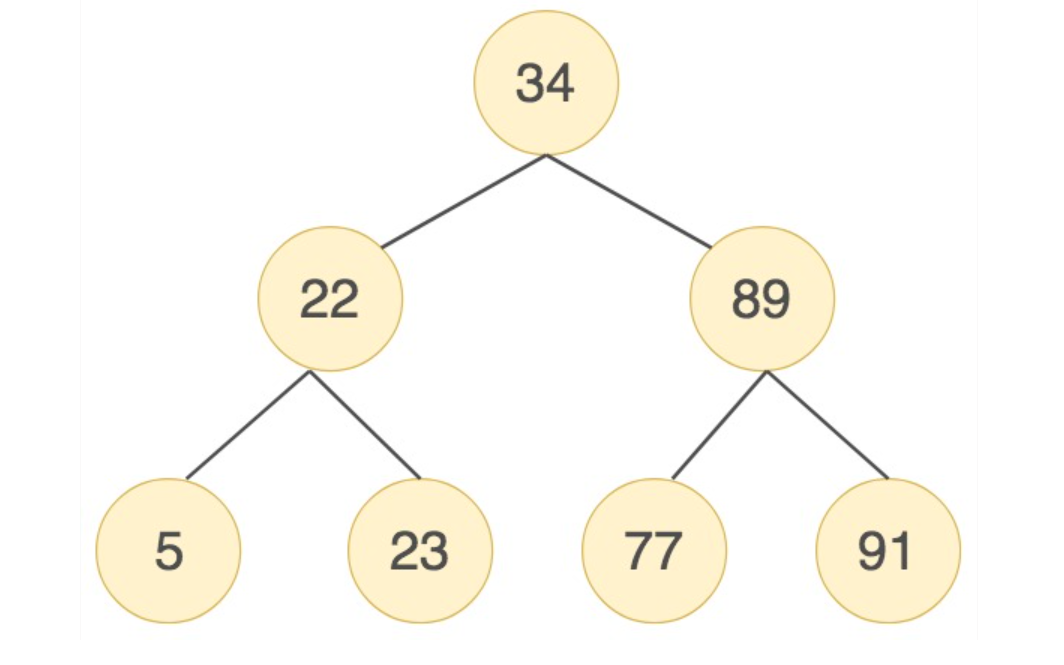
一般的二叉搜索树的建立,以首节点为根节点,后续的数据比当前数据小,则成为当前节点的左子树,否则成为右子树,对于序列(34,22,89,5,23,77,91)来说,创建出的二分查找树如下图:
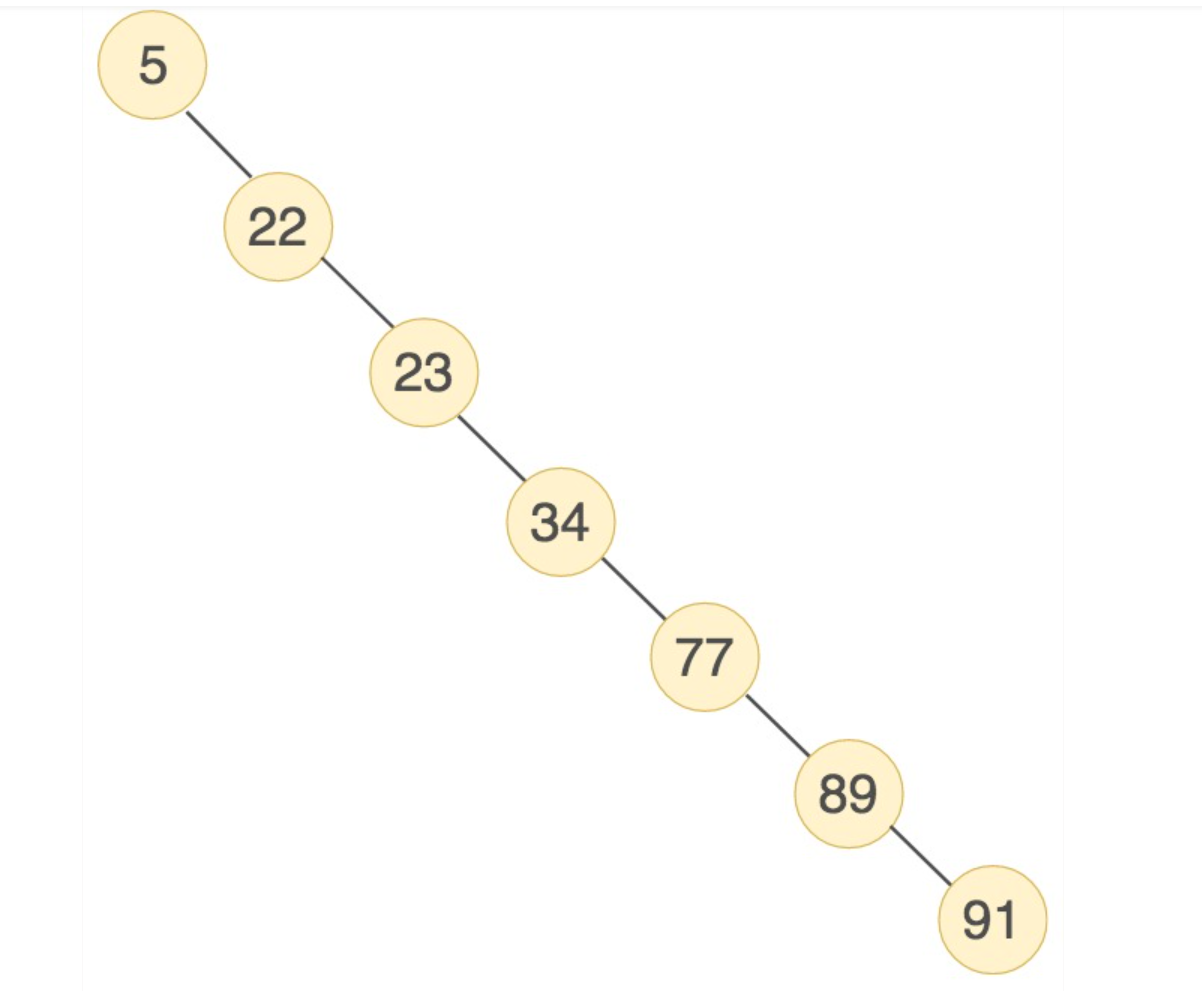
但是当数据比较极端,例如持续递增的一组序列,生成的二叉搜索树则会退化为链表,如下图:
为了避免极端数据情形导致查询恶化的情况,人们提出来平衡二叉搜索树(AVL树),它增加了每个节点左右子树高度差不能超过1的约束。
在平衡二叉搜索树中查找一个数据的时间复杂度近似为 O(log2n),在数据量比较大的时候,由于每个节点只有2个子树,因此层高和查询耗时也会显著增加。
随后人们又发现如果不用二叉树,而是平衡 M(M>2)叉树的情况下,以上问题可以得到较好的解决,M 的值在 Mysql 中约为 1200,当层高是 4 的时候最多已经可容纳 17 亿节点了。
B 树与 B+ 树
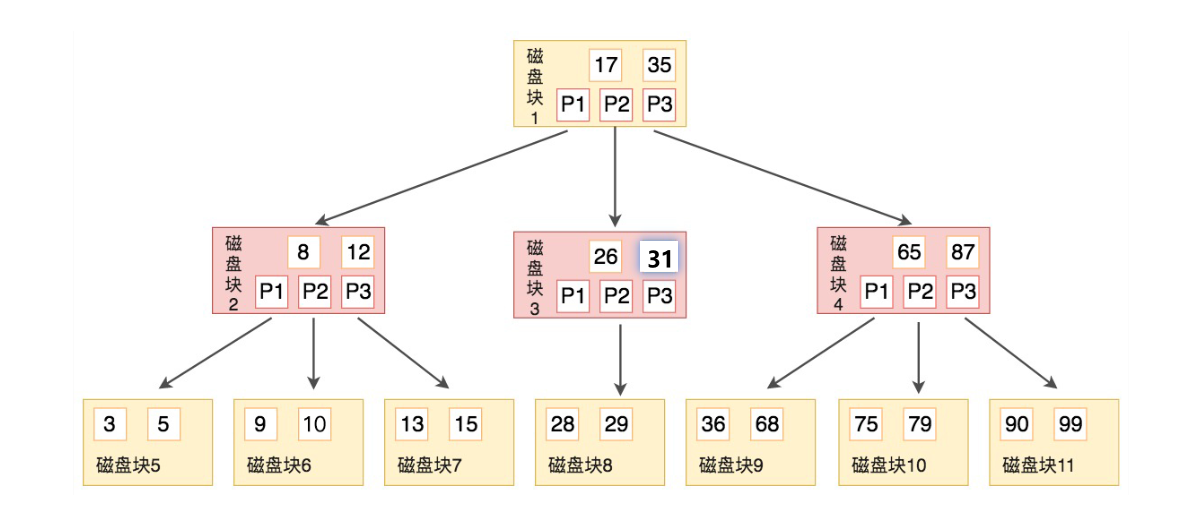
B树的英文是 Balance Tree,也就是平衡的多路搜索树,用来实现文件系统和某些数据库系统的索引,其结构如下图所示:
有个需要注意的地方:
- 非叶子节点出现的关键字在子节点中一般不再出现(如果有多条关键字相同的数据,当然叶子节点上还可能会出现)。
这也是 B 树与 B+ 树的重要区别之一,由于这样的实现,B 树的节点除了包含关键字,还包含关键字对应的行数据(在 B+ 树中,如果是主键索引,主键和行数据待在一起,如果是非主键索引,那么数据就是主键ID)。
B 树其实对于单个查询和范围查找已经支持的比较好了,不过单个查询的耗时不稳定,如果这个关键字在上层,耗时就短;如果随着时间推移关键字移动到了下层,查询时间就长;另外范围查找需要对树进行中序遍历,会根据上层节点去查询右子树。
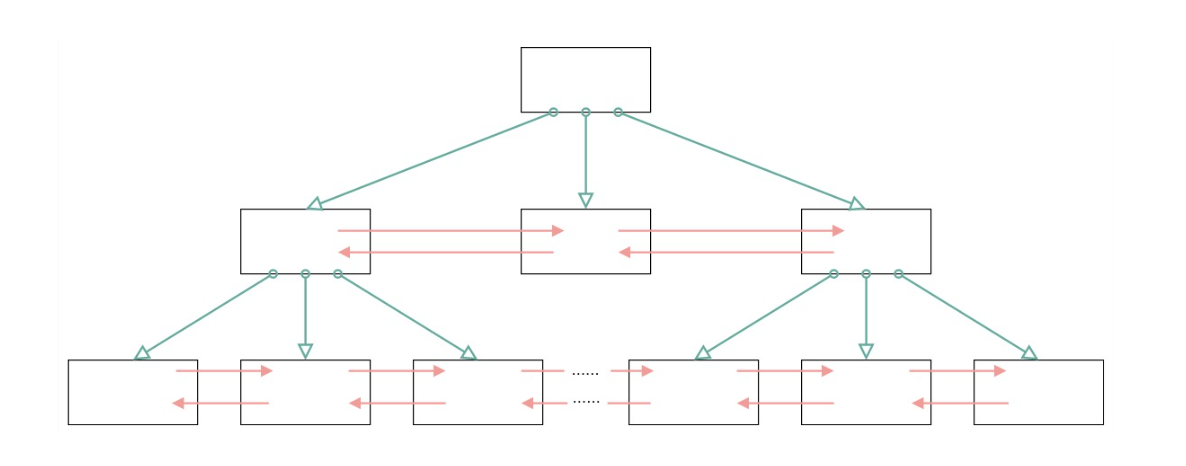
B+ 树针对上述场景做了优化,B+ 树把所有的数据都存放在了叶子节点,非叶子节点只存关键字,而且这个关键字一定是所指向子节点的最小值或最大值;B+ 树上所有的叶子节点间使用双向指针连接,在范围查找时可以从任意节点开始往 前/后 遍历。其结构如下图所示:
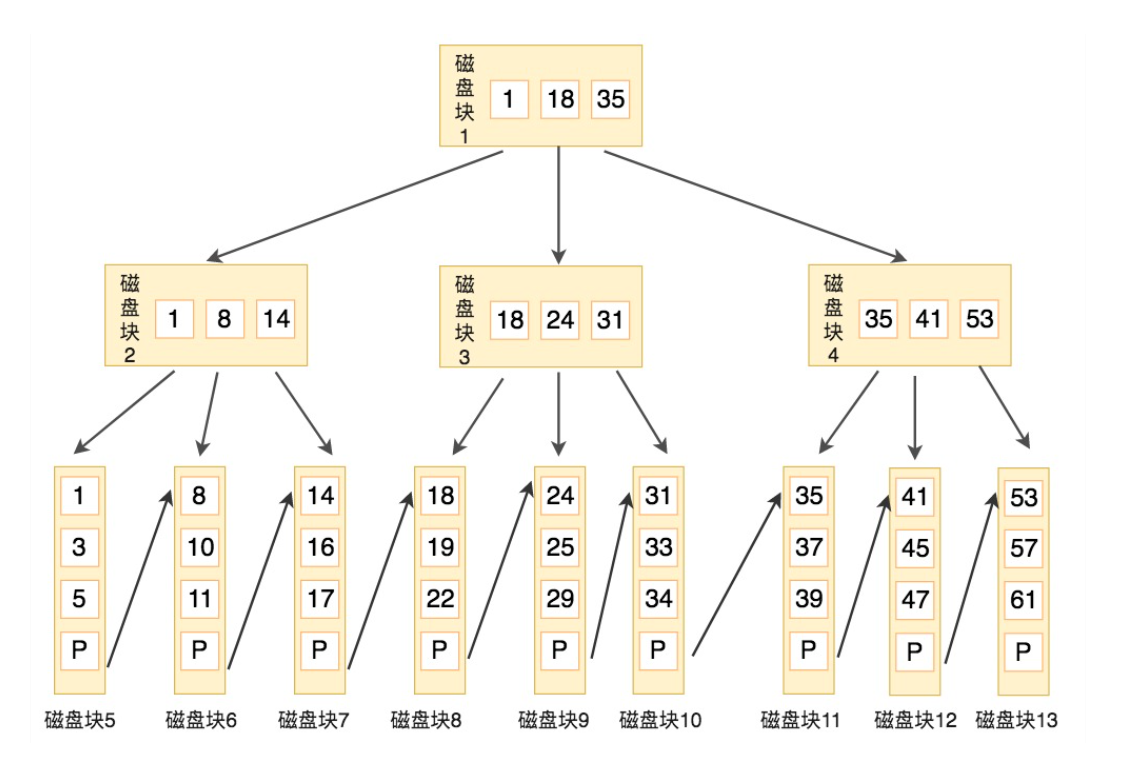
由于非叶子节点只存储关键字而不存储数据,因此 B+ 树比 B 树的非叶子节点能存下更多的关键字,同时由于数据都在叶子节点上,因此查询效率比较稳定。
如果要查询的字段不在非主键索引中,即使查询使用该索引,也需要在查到对应的主键后走主键索引拿到查询的字段值,这也被称为回表,有的时候走非主键索引查询速度比主键索引还快,原因可能是查询的字段刚好就是这个索引字段,此时不用回表。
B+ 树索引上的节点到底是什么
数据库中的数据是一行一行的,但是数据库的读取是按页为单位的,否则每次 I/O 操作指只能处理一行数据,效率太低了。在数据库中,无论是操作一行还是多行,都是将这些行所在的页进行加载。也就是说,数据库管理存储空间的基本单位是页。
一个 B+ 树的基本结构如下图所示,其实其中的每一个叶节点就是一个数据页。
数据页的大小可以使用如下命令查找,Mysql 中默认 16KB
1 | |
16KB 能存储上千条数据,如果仅依靠数据之间的链表指针查询仍然需要O(N)的复杂度,Mysql 在数据页的设计中利用槽(slot)进一步优化了这个过程。
Mysql 的页结构如下图所示,其中用户记录部分占了页结构的主要空间。
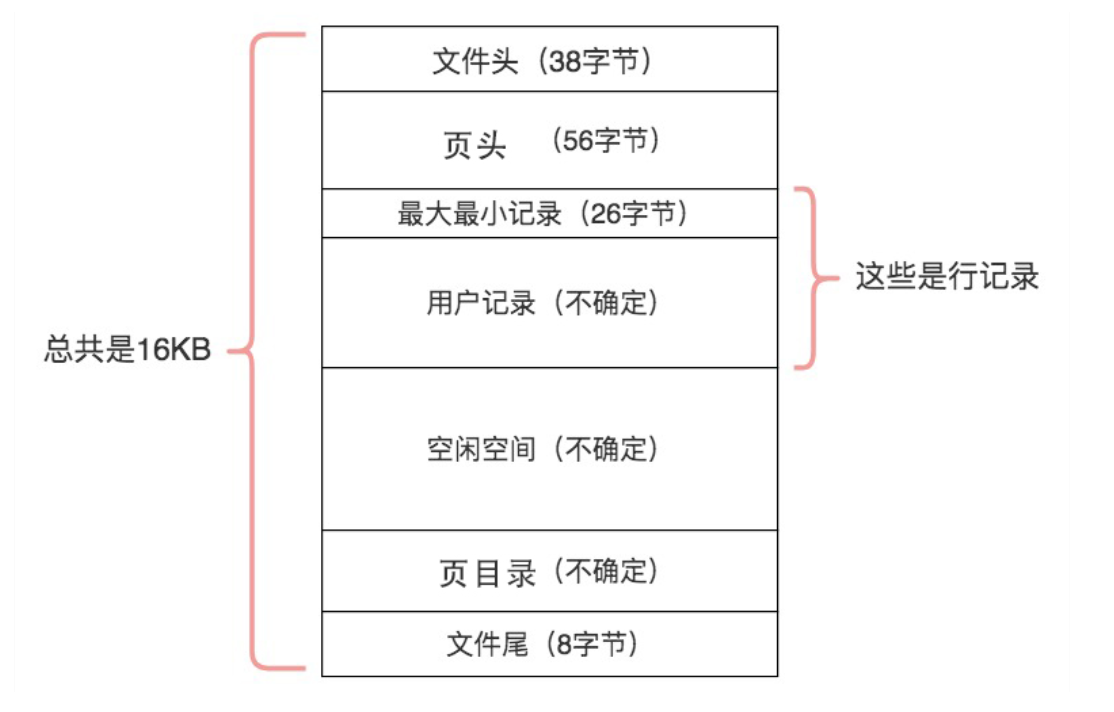
文件头中会有两个指针 FIL_PAGE_PREV 和 FIL_PAGE_NEXT 用来指向上一个数据页和下一个数据页,链表的结构使得数据页之间不需要是物理上的连续。
数据页中的页目录部分,就是业内记录的索引,流程如下:
- 将所有的记录分成几个组,这些记录包括最小记录和最大记录,但不包括标记为“已删除”的记录。
- 第 1 组,也就是最小记录所在的分组只有 1 个记录;最后一组,就是最大记录所在的分组,会有 1-8 条记录;其余的组记录数量在 4-8 条之间。这样做的好处是,除了第 1 组(最小记录所在组)以外,其余组的记录数会尽量平分。
- 在每个组中最后一条记录的头信息中会存储该组一共有多少条记录,作为 n_owned 字段。
- 页目录用来存储每组最后一条记录的地址偏移量,这些地址偏移量会按照先后顺序存储起来,每组的地址偏移量也被称之为槽(slot),每个槽相当于指针指向了不同组的最后一个记录。如下图所示:
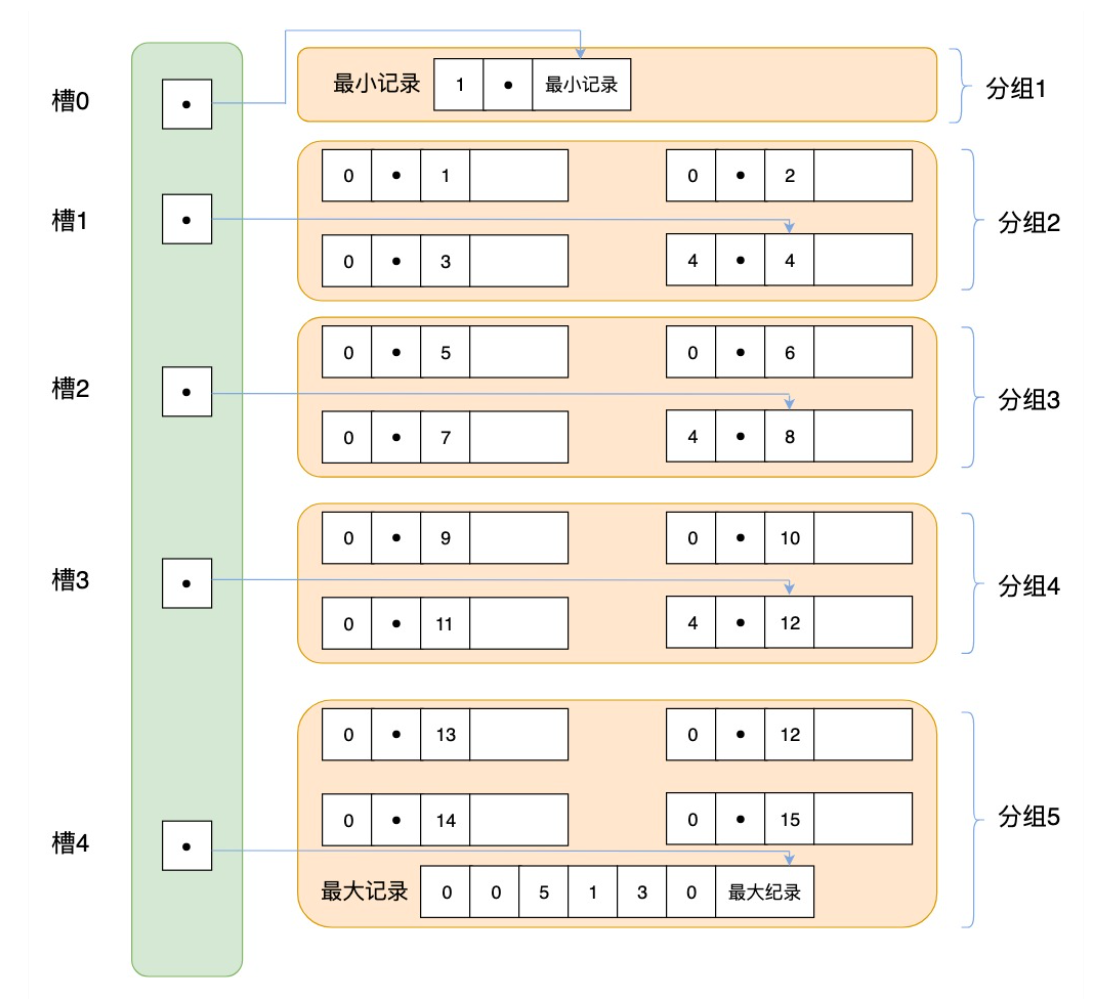
所以 Mysql 查询的全流程是:从 B+ 树的根开始,逐层检索,直到找到对应的叶子结点(即数据页),将数据页加载到内存,再借助页目录内的槽(slot)进行二分查找到一个记录分组,最后在分组中链表遍历查找记录。
LSM Tree
LSM(Log-Structure Merge Tree)日志结构合并树也是流行的索引的一种,它与B树及其变体有什么区别呢?
Mysql 的数据更新是原地更新,当写请求到来时需要同步更新索引的内容,但索引可能分布在任意位置,这种内容小,数量多而且位置分散的写操作被称为随机写入;数量少、规模较大的写入模式则称为顺序写入。
在机械磁盘上,顺序写入远快于随机写入:随机写入需要移动磁头,等待盘片转到磁头下方;即使上在 SSD 上,顺序写入的吞吐量也是要高于随机写入的。
LSM 的结构相比B树类更适合写多读少的场景,其实现思路如下:
- 收到写入时,将其加入内存中的有序映射数据结构,例如红黑树、跳表或字典树。这类数据结构可以按任意顺序插入键、高效查找键,并按排序顺序读出键。这个内存数据结构称为 内存表(memtable)。
- 当内存表超过某个阈值(通常为几兆字节)时,按排序顺序将它写成磁盘上的 SSTable 文件。这个新的 SSTable 文件称为数据库最新的 段(segment),它与较旧的段分别存放在独立文件中,每个段都有自己的索引。向磁盘写出新段期间,数据库可以继续向新的内存表实例写入;SSTable 写完后,旧内存表占用的内存即可释放。
- 读取某个键的值时,先在内存表和磁盘上最新的段中查找。如果没有找到,就依次查看更旧的段,直到找到这个键或查完最旧的段。如果任何段中都没有这个键,它就不存在于数据库中。
- 后台不时运行合并与压实过程,将段文件合并起来,并丢弃已经覆盖或删除的值。
SSTable(Sorted String Table)有序字符串表,指按照键值排序的结构。由于每次写入只需要更新到内存,且 memtable 写磁盘时是顺序写,所以写性能比较高,当然为了保证 crash 后内存数据不丢失,也用到了类似 wal 的思想来进行保证。
新的 SSTable 落盘后,会有后台进程定期的进行合并、压实,合并、压实的策略选择(Leveled、Tiered)可以进一步的偏向写优先或读优先。当然这会产生数倍的写放大,历史的 SSTable 可能分为(0-500、500-1000、1000-1500),而这个新的 SSTable 写入的键值涵盖(0-1500),那么合并时历史的3个 SSTable 都需要参与。
业界会采用分层的思想,最上层的 SSTable 索引范围可以重叠,下层的每一个 SSTable 容量是上层的10倍且范围不重叠,这样可以降低新 SSTable 范围很大而产生的写放大影响。如下图所示(简化了层数,实际上有多层):
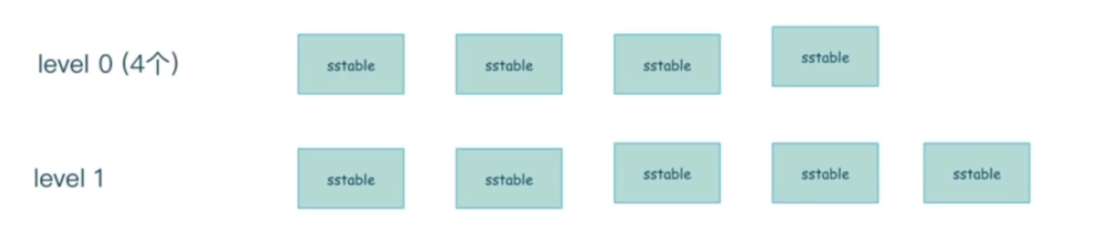
分层后不是每次落盘都跟全量数据归并,而是把数据分成不同“年龄”的层,只让新数据和小范围旧数据合并。
1 | |
RocksDB、Cassandra、ScyllaDB 和 HBase 采用的就是这样的算法。这些系统都受 Google Bigtable 论文的启发;SSTable 和 memtable 两个术语正是由该论文提出的。这一算法最初发表于 1996 年,名为 日志结构合并树(Log-Structured Merge-Tree,简称 LSM 树),它建立在更早的日志结构文件系统研究之上。因此,凡是以合并、压实有序文件为基本原理的存储引擎,通常都称为 LSM 存储引擎。